
换道突破
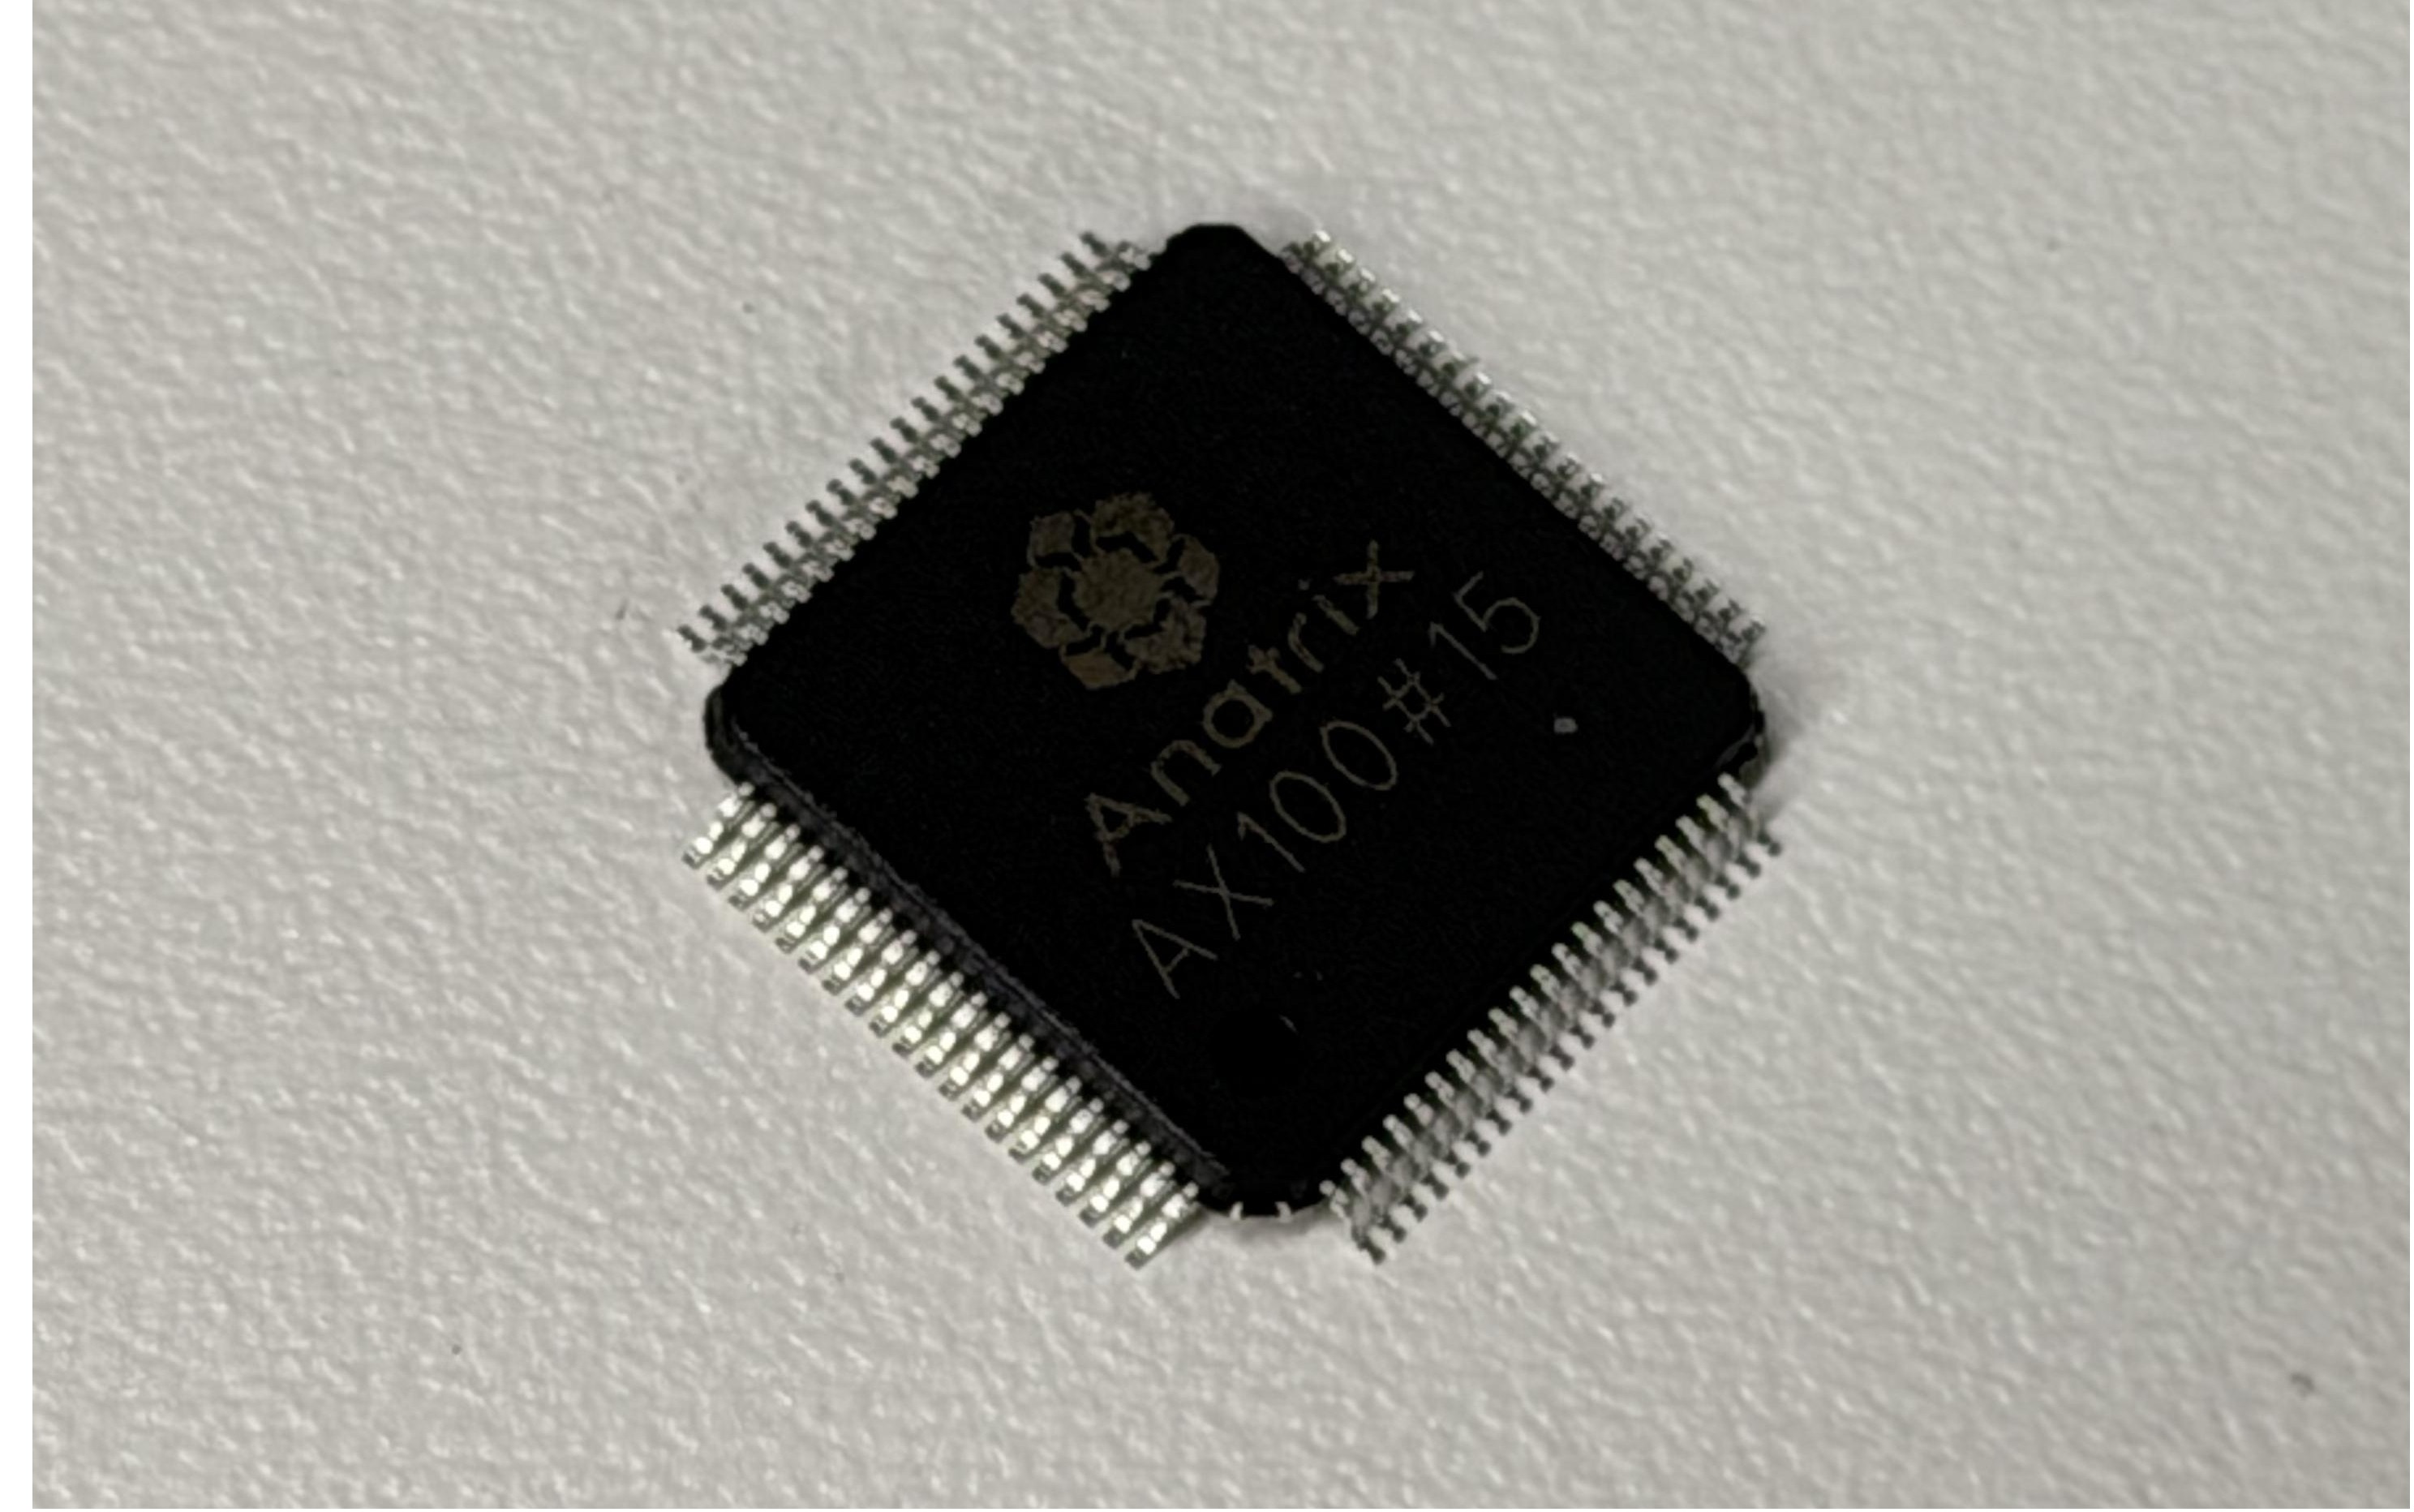
11 月 16 日消息,安纳智芯 AX100 芯片已于 10 月完成流片,单次矩阵方程求解不到 100 纳秒,功耗约 80 毫瓦,各项指标符合设计预期。
这是全球首颗可一步完成矩阵方程求解的全集成模拟计算芯片。
大模型训练、机器人控制、基站信号处理,底层核心都是矩阵求解。传统数字芯片需要反复迭代乘加运算,512 阶矩阵方程约要 5 亿次乘加,
耗时数十至上百微秒。而模拟计算思路截然不同:直接把矩阵映射到电路,依靠电路自平衡一次性输出结果,无需迭代。
模拟计算长期受制于可靠性与扩展性瓶颈。2025 年 10 月,北大孙仲团队在《自然・电子学》刊发成果,将精度做到 24 位定点、约千万分之一,
对标单精度浮点。时隔一年,安纳智芯便把这项实验室技术落地流片。
实测覆盖三大场景:大模型训练中,两款两百多万参数模型的训练开销分别降低 92%、56%;机器人运动控制规划提速 150%–500%,
三维重建与 SLAM 核心环节提速 200%–500%;通信场景下,
128×128 信道矩阵吞吐对比现有数字 ASIC、GPU 提升 20–207 倍,能效提升 27.6–61.3 倍。
该芯片无需先进制程,成熟工艺即可制造,实现全链路自主可控。安纳智芯 CEO 向锐表示,AX100 和 GPU 属于不同计算路线,
有望在芯片赛道开道超车,这也是国内企业首次有机会参与定义全新计算范式。