
芯存一体,领跑全球
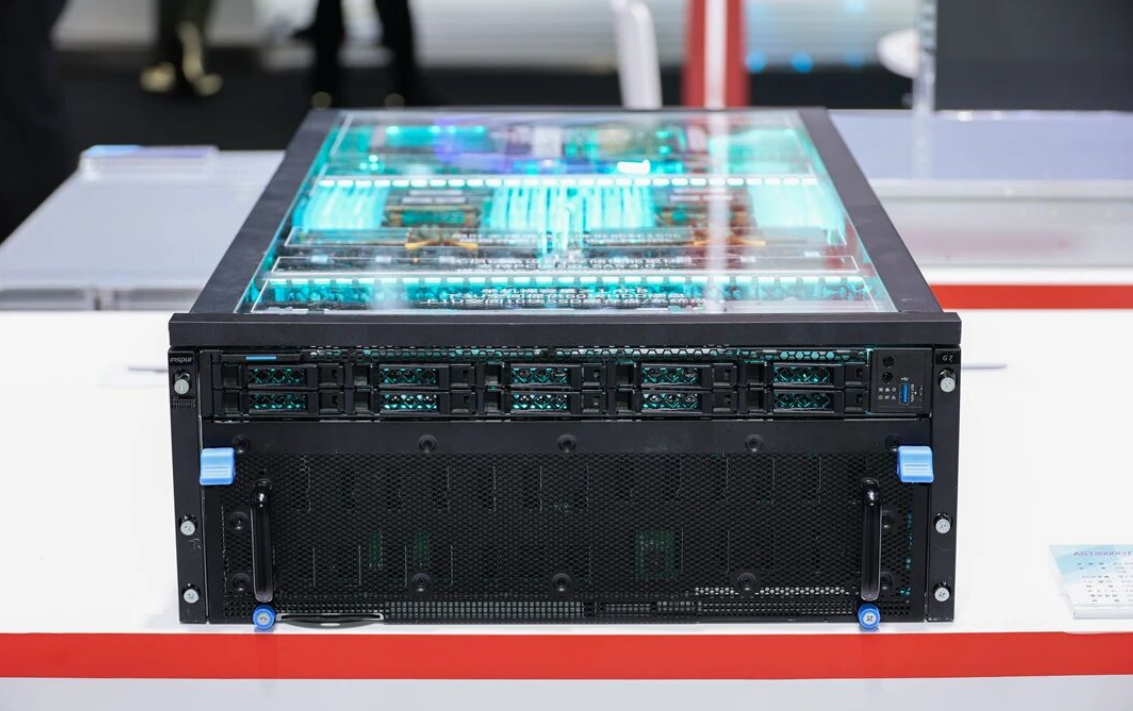
9 月 17 日消息,MLCommons 公布最新测试结果:搭载兆芯开胜 KH-50000 处理器的全国产 AI 存储方案 AS13000G7,
在国际权威 AI 存储基准 MLPerf Storage V3.0 中拿下五项第一,成为首个跻身全球第一梯队的全国产 AI 存储方案。
本次测试覆盖大模型训练 Checkpointing、大模型推理 KVCache、高性能计算 UNet3D 三大核心场景。AS13000G7 参与六项核心测试,
斩获五项单节点、单 U 性能双第一,同台对比 AMD EPYC、Intel Xeon 等海外旗舰方案,整体表现领先。
KVCache 推理场景是本次最大亮点。Llama3.1-8B 全落盘模式下单节点吞吐可达 14579 tok/s,为第二名的 1.7 倍;
混合内存模式吞吐 10181 tok/s,是第二名的 1.5 倍,在 8B/70B 全模型、全模式测试中实现包揽。
强悍性能的底层算力来自兆芯 KH-50000 处理器。芯片采用 Chiplet 芯粒封装,单颗集成 12 个 CPU Die,最高 96 核,
搭载 384MB 大容量三级缓存,支持 12 通道 DDR5 内存与 128 路 PCIe 5.0 接口,具备企业级 RAS 可靠性,
可 7×24 小时稳定承载高负载 AI 训练与推理任务。
MLPerf Storage V3.0 评测标准严苛,取消单次最优成绩统计,采用多轮循环加压机制,新增 KVCache 推理负载与跨节点一致性校验,
剔除临时调优的 “表演成绩”。AS13000G7 能够在此规则下夺冠,代表性能源于底层架构硬实力。
安全合规方面,整套方案基于兆芯自主 ZX86 架构打造,无海外核心组件依赖,内置国密硬件加速指令,
满足党政、金融、央国企等关键领域高等级安全要求。同时兼容主流 x86 生态,原有 AI 业务与开发框架无需重构即可平滑迁移。
此次突破印证,国产算力 + 存储组合已经具备全球顶尖竞争力,为信创领域 AI 存储选型树立了可落地的国产标杆。